  rawtext = c("Luke, I am your father.",
              "When I was your age, we didn't have Star Destroyers...",
              "Luke, may I have some privacy, please.",
              "No Luke, you're not old enough.",
              "Hey, Dad, look at me! I'm jedi!",
              "Harry Potter was a highly unusual boy in many ways.",
              "Get out of the way, Harry Potter.",
"Listen to me Harry.")主成分分析(Principal Component Analysis, PCA)
1 潜在意味分析
次のような文章のデータを考えてみる.
- Luke, I am your father.
- When I was your age, we didn’t have Star Destroyers…
- Luke, may I have some privacy, please.
- No Luke, you’re not old enough.
- Hey, Dad, look at me! I’m jedi!
- Harry Potter was a highly unusual boy in many ways.
- Get out of the way, Harry Potter.
- Listen to me Harry.
人間が見ると,出てくる単語を使って各文章の特徴がつかめそうである.さらには,各文章の背後に何らかのトピックがありそうにも思える.
このような文章データをどのように数値の情報に落とせばいいだろうか?ひとつの方法はBag of Words(BoW)形式にすることである.
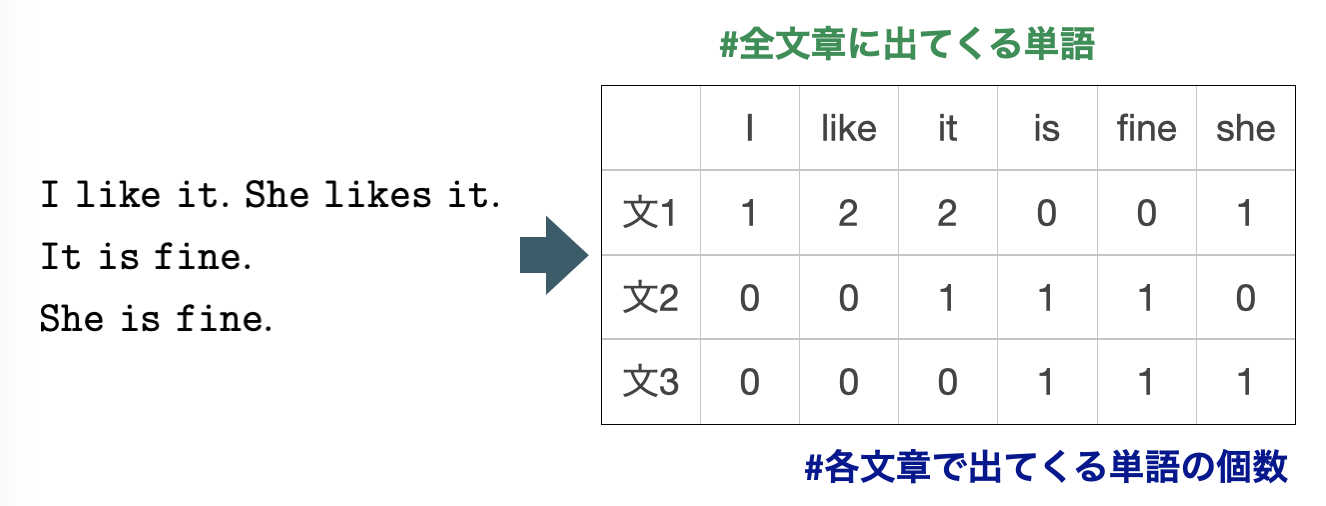
Rを使ってまずはこのBoW形式のデータを作ってみよう.
パッケージtmをインストールして読み込む.
library(tm)要求されたパッケージ NLP をロード中ですデータを読み込んでコーパスを作成する.
sentences = VCorpus(VectorSource(rawtext))元の文章へのアクセスはcontentを用いる
sentences[[1]]$content[1] "Luke, I am your father."sentences[[2]]$content[1] "When I was your age, we didn't have Star Destroyers..."次に文章のクリーニングを行う.大文字を小文字に統一,数字を削除,ストップワードを削除,などを行う.
sent.clean = tm_map(sentences, content_transformer(tolower))
sent.clean = tm_map(sent.clean, removeNumbers)
sent.clean = tm_map(sent.clean, removeWords, stopwords("en"))
sent.clean = tm_map(sent.clean, removePunctuation)
sent.clean = tm_map(sent.clean, stripWhitespace)
削除後の文章は次のようになる.
sent.clean[[1]]$content[1] "luke father"sent.clean[[2]]$content[1] " age star destroyers"BoW形式への変換を行う.
bow <- DocumentTermMatrix(sent.clean,control=list(wordLengths=c(2,20)))wordLengthsのオプションでは,長さが2-20の単語のみに限定して変換している.URLのような長すぎる単語を対象にしたくないためである.
bow = bow[, findFreqTerms(bow,2)]
as.matrix(bow)
Terms
Docs harry luke potter
1 0 1 0
2 0 0 0
3 0 1 0
4 0 1 0
5 0 0 0
6 1 0 1
7 1 0 1
8 1 0 0オプションfindFreqTermsでは,2つ以上の文章で出てくる単語のみを対象にするように指定している.
1.1 行列の特異値分解
以上の手続きによって文章のデータが行列形式のBoW形式へと変換された.そのため,BoW形式のデータを行列とみなして,線形代数の知識で解析を進めてみよう.
行列の特異値分解を思い出そう.任意の実n\times p行列Xは次のように特異値分解が可能である X = UDV^{T} ただし,D={\rm diag}(d_{1},\dots, d_{r}), d_{j} > 0, r = {\rm rank}(X)であり,U^{T}U = V^{T}V = I(単位行列)である.図示すると次のようになる:
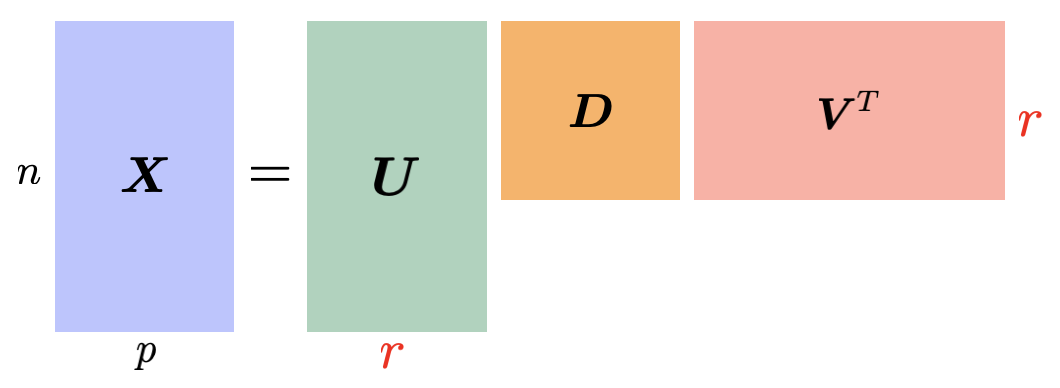
特異値分解では左辺のXを右辺のU, D, Vの行列積で完全に復元できる.しかしながら, 特にBoW形式の場合はXが横長の行列になるため,結果としてUやVのサイズも大きくなり得る. サイズの小さな行列でXを近似したい場合は,k < rを用いて右辺の行列サイズを小さくする.
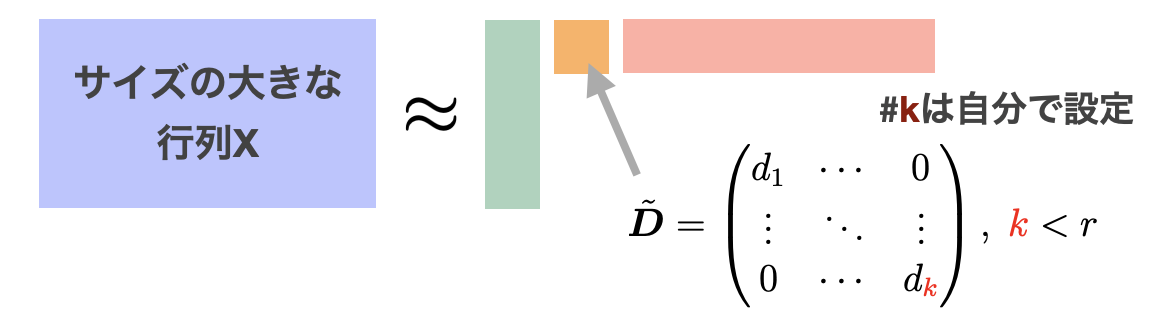
ただし,近似の精度はkに依存することに注意が必要である.kがrに近ければ当然Xをよく近似できているし,kがrよりかなり小さければ近似は悪い.これをRで確かめてみよう.
bow <- DocumentTermMatrix(sent.clean,control=list(wordLengths=c(2,20)))
bow = bow[, findFreqTerms(bow,1)]

xx = as.matrix(bow)
result = svd(xx); str(result)
List of 3
$ d: num [1:8] 2.88 2.28 2 1.77 1.73 ...
$ u: num [1:8, 1:8] 3.63e-18 4.58e-17 3.18e-17 -3.90e-17 -4.24e-16 ...
$ v: num [1:24, 1:8] -2.60e-17 -3.01e-01 -4.52e-16 -8.35e-18 8.52e-18 ...k=rの場合はちゃんと元の行列を再現していることが確認できる.
ap.xx = result$u %*% diag(result$d) %*% t(result$v)
sum(abs(ap.xx - xx))
[1] 4.200184e-14kの値を変えながら近似してみよう.
#本文のnotationに合わせる
U = as.matrix(result$u)
D = diag(result$d)
V = as.matrix(result$v)
k = 2
ap.xx = U[,1:k] %*% D[1:k,1:k] %*% t(V[,1:k])
sum(abs(ap.xx - xx))[1] 25.15317k = 5
ap.xx = U[,1:k] %*% D[1:k,1:k] %*% t(V[,1:k])
sum(abs(ap.xx - xx))[1] 11.810411.2 特異値分解による近似の解釈
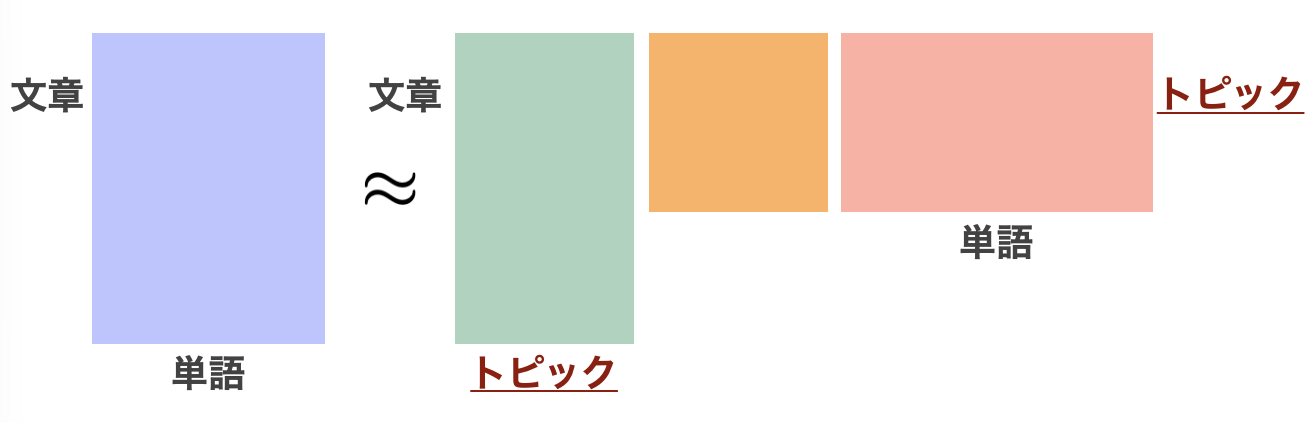
- 緑の行列:各文章がどのトピックに属しているかの情報
- 赤の行列:各トピックの特性(単語に対する重みと解釈)
実際に赤の行列Vの中身を見てみよう.
rownames(V) = colnames(xx)
round(V[,1],2)
age boy dad destroyers enough father get
0.00 -0.30 0.00 0.00 0.00 0.00 -0.16
harry hey highly jedi listen look luke
-0.53 0.00 -0.30 0.00 -0.07 0.00 0.00
many may old please potter privacy star
-0.30 0.00 0.00 0.00 -0.46 0.00 0.00
unusual way ways
-0.30 -0.16 -0.30 round(V[,2],2) age boy dad destroyers enough father get
0.00 0.00 0.00 0.00 -0.23 -0.17 0.00
harry hey highly jedi listen look luke
0.00 0.00 0.00 0.00 0.00 0.00 -0.73
many may old please potter privacy star
0.00 -0.33 -0.23 -0.33 0.00 -0.33 0.00
unusual way ways
0.00 0.00 0.00 Vの1列目はharryやpotterに絶対値の高い重みがついており,一方で2列目にはlukeに重みがついている.さらには,それぞれの単語の重みは1列目と2列目では排反している.そのため,トピック1はハリーポッター,トピック2はルークのように解釈できる.
そのため,UもしくはUDの第1列と第2列で散布図を描いてみると次のようになる.
plot(U[,1]*D[1,1], U[,2]*D[2,2])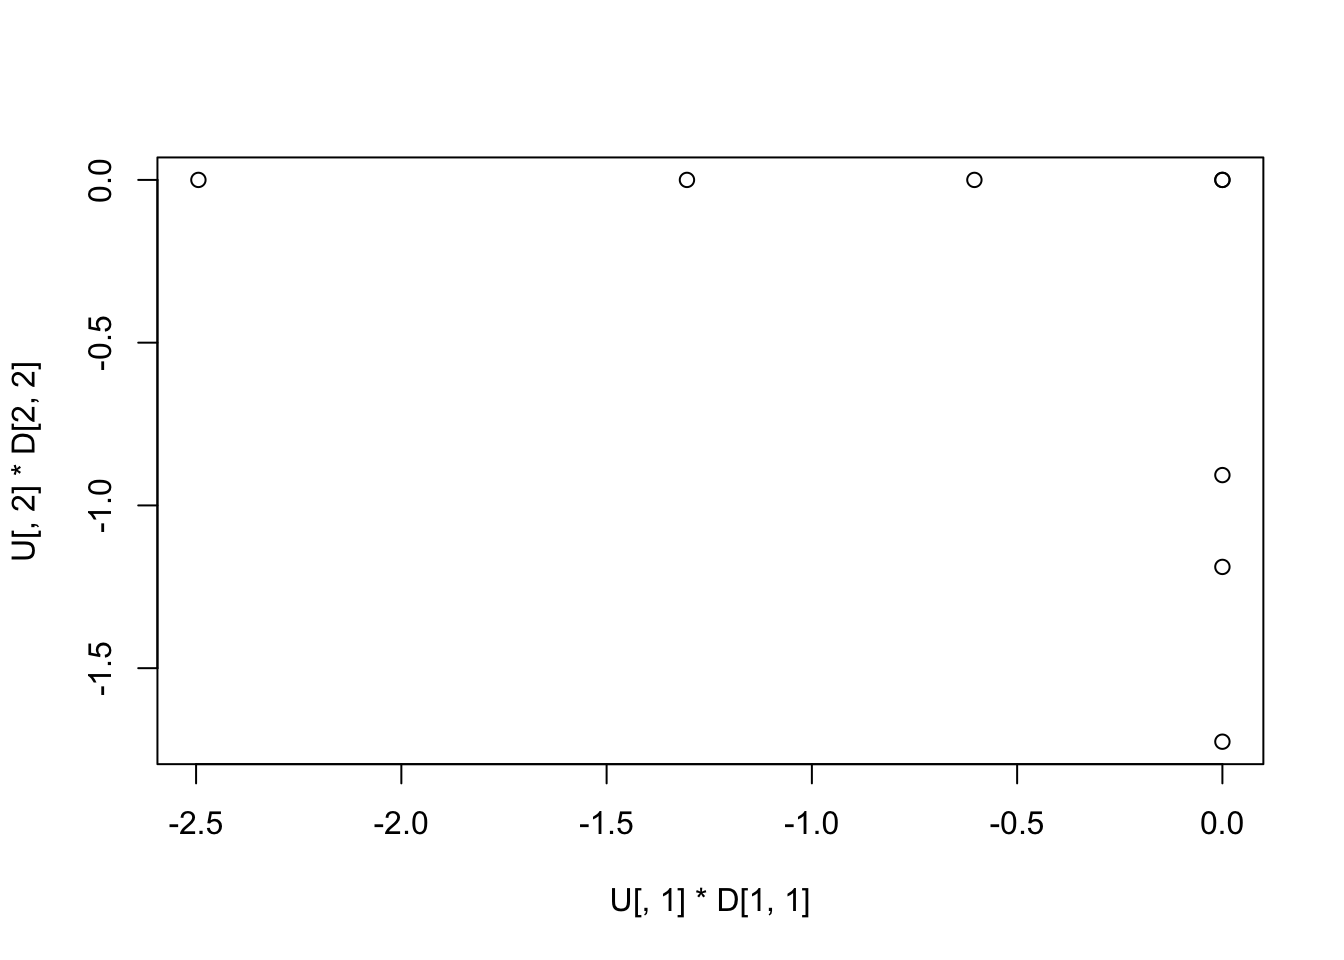
点が直交する方向にきれいに分類されていることがわかる.このプロットには事前に一切の教師データを使っていない.
2 主成分分析
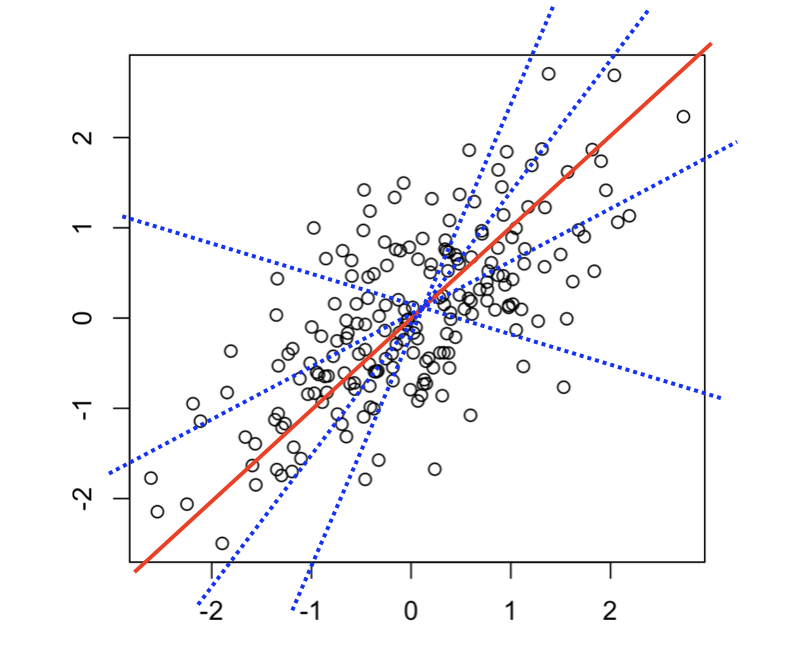
主成分分析は教師データを使わない教師なし学習のひとつであり,大規模データの視覚化が可能である.データを理解しやすい変数へと削減する次元削減を伴う.例えば次のプロットを見てみよう.
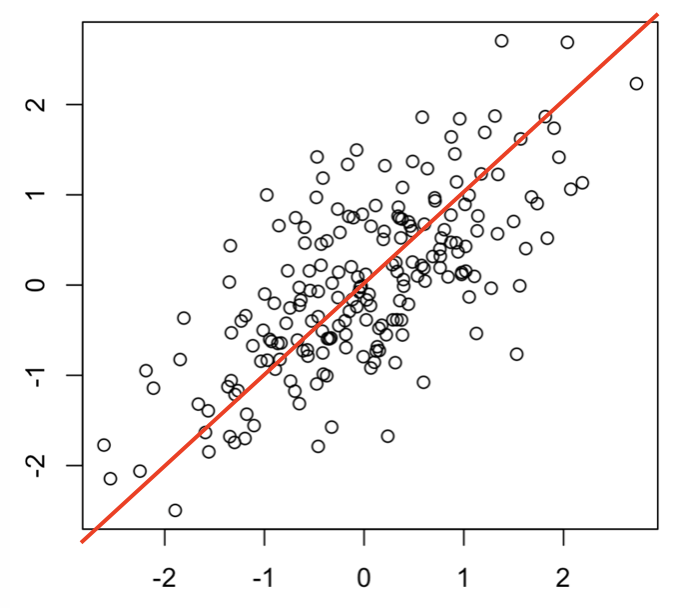
これは2次元のデータであるが,赤い直線の軸(1次元)に点を落とせば,1次元データとして解釈できそうである.これをより大きな次元のデータに適用し,低次元空間(例えば2次元空間)に落とすことで解釈を容易にするものである.
主成分分析の原理は,複数の変数を線形的に組み合わせて新しい変数を作成するところにある.いま,元のデータを
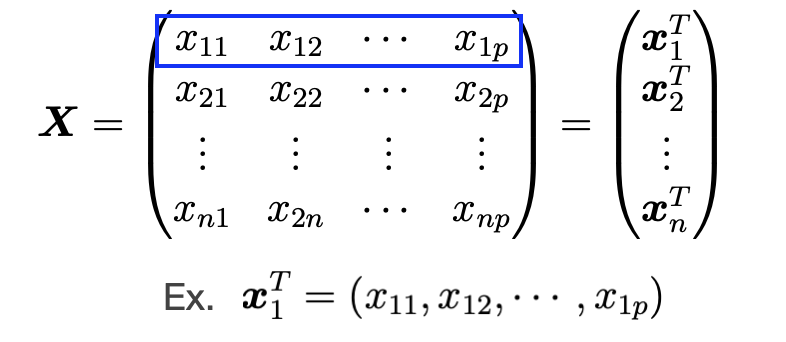
で書くことにすると,主成分スコアと呼ばれる新しい変数は,
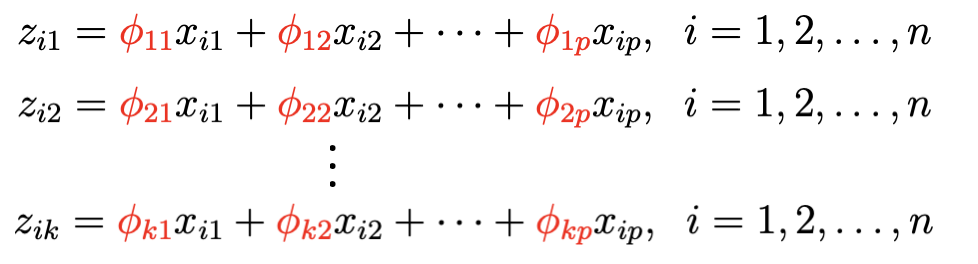
で与えられる.ベクトル表記するとz_{ik} = \bm{\phi}_{k}^{T}\bm{x}_{i}である.これにより,元の次元pから新しい次元kへと次元が削減されている.それでは,これらの\bm{\phi}_{1},\dots, \bm{\phi}_{k}はどのように推定すれば良いだろうか?実際にRでやってみよう.
まずはデータサイエンスコンソーシアムにある民力データをインプットする.
Ppower = structure(list(
  人口 = c(5650573, 1479358, 1405060, 2350026, 1173722, 1225990, 2116210, 2991804, 2006717, 2022780, 6980889, 6001032, 12082143, 8600109, 2455996, 1118661, 1175071, 824824, 882678, 2200896, 2106917, 3773140, 7027499, 1857773, 1353893, 2565424, 8651977, 5566566, 1439040, 1073434, 614650, 752534, 1957269, 2869555, 1512333, 823304, 1029356, 1496929, 809554, 5010859, 877040, 1511064, 1862895, 1227107, 1177455, 1769932, 1362128),
  世帯数 = c(2522295, 551806, 488354, 856527, 410308, 387732, 716505, 1039865, 701919, 719576, 2660152, 2348339, 5776805, 3602950, 810483, 367754, 417164, 260744, 319146, 777553, 701408, 1347330, 2634915, 672654, 460199, 1048788, 3657248, 2187130, 525535, 411063, 216963, 267189, 732253, 1161859, 620630, 305362, 389901, 603933, 341873, 2023115, 293751, 591017, 690743, 480113, 475947, 759742, 501093),
  事業所数 = c(270504, 74341, 72456, 115297, 65300, 70523, 109652, 135383, 103835, 109637, 266775, 206793, 724769, 309441, 142123, 64734, 72638, 52855, 52789, 128969, 122425, 207923, 360358, 93292, 61941, 142119, 483964, 252132, 53073, 58997, 31926, 45344, 92823, 145555, 78099, 45498, 57335, 80613, 46354, 242611, 44673, 76403, 86658, 65302, 61679, 91011, 73179),
  県民所得 = c(145293, 32498, 34152, 61092, 27294, 29851, 56554, 86778, 61184, 59127, 186180, 184026, 498507, 264122, 66880, 33114, 33792, 23962, 22807, 60262, 58868, 121941, 243703, 55070, 43329, 73961, 267120, 147639, 38668, 26856, 15064, 18199, 53126, 80700, 42661, 22142, 27645, 34490, 18360, 131374, 21386, 34008, 45425, 31528, 28520, 39962, 27189),
  国税 = c(1379098, 242730, 224269, 735121, 186373, 202270, 390824, 746384, 425157, 464797, 1355243, 1704591, 15801117, 3160545, 530773, 318907, 317154, 179464, 187752, 488468, 443046, 985478, 3401779, 576682, 244889, 797590, 4958613, 1389761, 186130, 300029, 98206, 115835, 680361, 802421, 516172, 175131, 365676, 415626, 128103, 1368856, 143449, 209290, 312474, 320990, 186803, 295756, 291000),
  地方税 = c(546638, 131442, 123476, 245372, 97512, 107894, 210846, 320761, 225878, 209336, 633293, 555876, 3936025, 880703, 242825, 116521, 125988, 98482, 93218, 224361, 209845, 452095, 1008531, 208908, 141459, 249199, 990905, 501143, 113016, 87101, 53957, 65928, 186210, 281009, 140933, 83583, 102315, 125857, 63664, 469018, 81241, 107182, 151102, 102805, 91709, 138525, 92298),
  農業産出額 = c(10579, 2402, 2587, 1870, 2208, 2349, 2640, 4194, 2786, 2210, 2004, 4319, 280, 751, 3281, 835, 684, 597, 823, 2425, 1239, 2582, 3259, 1266, 704, 752, 362, 1649, 546, 1056, 703, 650, 1296, 1065, 777, 1201, 862, 1347, 1019, 2313, 1450, 1339, 3242, 1427, 3108, 4019, 931),
  林業産出額 = c(463.7, 88.2, 193.4, 76.1, 123.2, 62.5, 149.7, 79.7, 118.3, 131.3, 28, 23.7, 7.4, 8.3, 328.5, 24.4, 28.5, 24.9, 16.3, 536, 125.6, 145.6, 42.9, 96.1, 12.9, 28.7, 5.1, 46.3, 67.5, 65.8, 23.4, 51.1, 79.4, 47.9, 34, 70.6, 51.5, 67.5, 84.8, 119.8, 15, 47.3, 144.7, 180.8, 206.9, 72.4, 2.3),
  水産水揚 = c(761331, 107727, 108752, 373037, 5599, 4116, 51131, 173448, 11282, 3843, 14422, 281435, 45242, 36807, 73953, 17797, 29363, 9535, 3979, 2384, 575, 151944, 93271, 128672, 12620, 12236, 46070, 105143, 313, 21172, 126348, 61496, 18068, 53694, 98592, 12157, 36919, 74821, 15082, 78550, 79678, 115895, 23470, 30663, 16694, 133139, 5835),
  工場数 = c(10668, 3188, 4126, 5782, 4130, 5971, 8494, 11160, 10953, 12898, 28809, 10820, 49580, 18475, 14068, 5741, 8829, 6217, 5417, 12478, 17084, 22593, 42281, 8372, 5823, 15099, 47403, 19859, 5559, 4587, 1812, 2707, 7403, 10505, 3615, 3233, 4534, 5128, 2434, 11559, 2956, 4184, 4028, 2951, 2946, 5304, 2767),
  工業出荷額 = c(51199, 10997, 20209, 32677, 11731, 26287, 49706, 96742, 74427, 69710, 124108, 105257, 104363, 181354, 40669, 32461, 21648, 15560, 21364, 53691, 44852, 153746, 344743, 75093, 56171, 43694, 146300, 117753, 19885, 19097, 10348, 9349, 61734, 66627, 50043, 15083, 20019, 30720, 5124, 70113, 14034, 12285, 22778, 29060, 11575, 17355, 5913),
  就業者数 = c(2796200, 731000, 715500, 1169800, 571000, 631400, 1052500, 1555900, 1049600, 1063500, 3711500, 3130600, 6653800, 4433600, 1261400, 593600, 632900, 446100, 465000, 1189800, 1110100, 2042800, 3808400, 971300, 700800, 1308300, 4342700, 2649600, 675500, 511500, 314600, 386100, 963500, 1458000, 751700, 397700, 511900, 727300, 409300, 2461800, 437800, 704300, 901800, 588600, 576700, 842600, 599400),
  商店販売額 = c(20247834, 3693933, 3525821, 10933309, 2714120, 2968623, 4898557, 6574412, 5646460, 5362438, 15024770, 12294183, 176704287, 20028848, 7330619, 3305066, 4280880, 2315651, 1928163, 6464420, 5234017, 11266379, 41525491, 3828670, 2543282, 7298154, 63063743, 13177565, 2096700, 1952240, 1507277, 1705491, 5518944, 12567940, 3595032, 1821844, 4282163, 3923283, 1705016, 22034564, 1875024, 3298063, 4184779, 2695568, 2696485, 4331959, 2492057),
  電力消費 = c(11256, 2671, 2631, 4396, 2152, 2327, 3922, 5721, 3931, 4086, 13131, 11438, 27472, 16612, 4694, 2465, 2652, 1915, 1882, 4768, 4349, 7685, 14596, 3906, 2809, 5784, 18797, 11598, 2955, 2416, 1305, 1613, 4232, 6198, 3149, 1839, 2265, 3163, 1760, 9979, 1711, 2888, 3546, 2465, 2286, 3430, 2808),
  預貯金 = c(336487, 70174, 76438, 125693, 56790, 67083, 113222, 190256, 128826, 147553, 445037, 360828, 1915951, 584015, 172060, 97496, 92795, 71145, 64533, 180124, 179226, 304204, 637306, 143158, 97621, 228896, 824728, 435055, 105170, 95195, 41221, 51195, 136132, 222559, 105320, 71840, 101386, 115526, 59042, 299960, 53572, 78559, 97835, 72956, 55772, 91718, 52904),
  公共事業費 = c(1611254, 324170, 339411, 391923, 328282, 363756, 466686, 450254, 382702, 333528, 903250, 646053, 1841386, 948689, 664364, 278946, 278602, 194788, 245716, 582792, 563226, 867838, 1007471, 415260, 298574, 457126, 1294091, 1009971, 254356, 228098, 181101, 329440, 365125, 645990, 305193, 215867, 191557, 329903, 260348, 735627, 207276, 272204, 309731, 306699, 267535, 380425, 283715),
  着工住宅数 = c(49183, 8971, 8906, 19382, 6664, 7088, 13481, 23206, 19484, 17747, 72126, 60471, 188302, 101084, 15668, 7775, 9502, 5856, 7025, 15981, 14000, 34412, 70316, 15601, 12607, 23413, 85977, 45787, 9990, 6691, 4760, 4774, 15149, 23967, 10257, 5195, 7910, 10931, 5598, 51434, 5540, 9681, 13141, 9589, 8033, 12892, 13502),
  自動車台数 = c(3720320, 999912, 983234, 1557230, 831589, 920699, 1550263, 2365525, 1595447, 1706757, 3832929, 3373580, 4625157, 3964137, 1771751, 866263, 858386, 635202, 720537, 1844308, 1626468, 2751131, 4851772, 1421670, 940723, 1356068, 3797449, 2925885, 821632, 738326, 453280, 542109, 1454545, 1808053, 1053543, 610301, 744671, 996782, 567087, 3112592, 632060, 910794, 1279125, 867733, 893443, 1297224, 913662),
  教育費 = c(945495, 264053, 277808, 365365, 214608, 215490, 351941, 438782, 295741, 313757, 832895, 736001, 1441757, 963372, 395379, 184740, 200529, 151988, 153883, 352944, 319052, 504035, 867190, 273472, 232672, 339072, 1103702, 802070, 218003, 180626, 113527, 163292, 293783, 414000, 229287, 148696, 163737, 230488, 148154, 635363, 147475, 258530, 273402, 213217, 188294, 312311, 268853),
  書雑販売高 = c(177154, 40213, 35185, 70995, 30773, 29966, 56559, 74995, 54373, 62134, 194648, 185226, 651856, 278248, 78228, 37306, 38809, 23187, 25357, 62595, 58403, 111198, 248864, 49243, 34451, 99948, 339064, 165429, 32105, 26208, 17413, 19589, 54688, 88627, 44041, 24585, 29673, 40073, 20110, 153253, 20630, 36161, 43373, 37584, 26549, 42934, 25107),
  新聞部数 = c(2235101, 531167, 471524, 812314, 442938, 462638, 838845, 1201361, 827563, 911181, 2799644, 2466991, 6204959, 3584938, 857258, 454741, 488113, 311684, 356942, 911926, 823934, 1477137, 2992935, 791054, 539862, 1168330, 4095042, 2422661, 738826, 464681, 263817, 319999, 787074, 1164217, 723473, 328303, 434015, 575140, 291492, 2095616, 316228, 524011, 580911, 452290, 387525, 549811, 461005),
  テレビ台数 = c(1652081, 470546, 443942, 719845, 385189, 371689, 616923, 855602, 609461, 624976, 2002571, 1723500, 3760022, 2631293, 788506, 347764, 369504, 242457, 280089, 726782, 628441, 1171300, 2146138, 554418, 371495, 775494, 2436021, 1518982, 385214, 334007, 193871, 251843, 598564, 998459, 534099, 232571, 320069, 475910, 242928, 1467072, 247390, 490154, 553543, 363602, 352616, 598134, 341780),
  電話回線数 = c(6154045, 1384375, 1300483, 2525483, 1087529, 1127332, 1991887, 3101445, 2048136, 2117015, 7483994, 6543652, 19903994, 10255787, 2339482, 1114307, 1315585, 838121, 951727, 2346667, 2228641, 4094035, 8364374, 1976787, 1422760, 3041469, 11932939, 5725895, 1504484, 1109248, 617878, 749383, 2085438, 3293572, 1582442, 855056, 1143094, 1554295, 845188, 5705959, 778304, 1465214, 1785486, 1236703, 1170237, 1745418, 1362962),
  郵便通数 = c(650837, 114626, 114618, 351549, 93834, 105540, 171140, 245032, 183537, 179973, 1070397, 678694, 6571615, 1227549, 315617, 119494, 156219, 79761, 109111, 267783, 205592, 429026, 1140096, 207548, 132484, 528908, 2225793, 708119, 200882, 102018, 58227, 75407, 571083, 408882, 142541, 74790, 149966, 143022, 76256, 788353, 71433, 141764, 209835, 105382, 97353, 140978, 90992),
  面積 = c(83455, 9607, 15279, 7286, 11612, 9323, 13783, 6096, 6408, 6363, 3797, 5157, 2187, 2416, 12583, 4247, 4185, 4189, 4465, 13585, 10598, 7780, 5163, 5777, 4017, 4613, 1894, 8394, 3691, 4726, 3507, 6708, 7113, 8478, 6111, 4145, 1876, 5677, 7105, 4975, 2440, 4095, 7405, 6339, 7735, 9188, 2274)),
  .Names = c("Population", "Households", "Establishments", "Prefectural income", "National tax", "Local tax", "Agricultural output", "Forestry output", "Fishery catches", "Factories", "Industrial shipments", "Employed persons", "Commercial sales", "Electricity consumption", "Deposits and savings", "Public works expenditure", "Housing starts", "Automobiles", "Education expenditure", "Book and magazine sales", "Newspaper circulation", "Televisions", "Telephone lines", "Mail volume", "Area"), row.names = c("Hokkaido", "Aomori", "Iwate", "Miyagi", "Akita", "Yamagata", "Fukushima", "Ibaraki", "Tochigi", "Gunma", "Saitama", "Chiba", "Tokyo", "Kanagawa", "Niigata", "Toyama", "Ishikawa", "Fukui", "Yamanashi", "Nagano", "Gifu", "Shizuoka", "Aichi", "Mie", "Shiga", "Kyoto", "Osaka", "Hyogo", "Nara", "Wakayama", "Tottori", "Shimane", "Okayama", "Hiroshima", "Yamaguchi", "Tokushima", "Kagawa", "Ehime", "Kochi", "Fukuoka", "Saga", "Nagasaki", "Kumamoto", "Oita", "Miyazaki", "Kagoshima", "Okinawa"),
  class = "data.frame")
head(Ppower)
Population Households Establishments Prefectural income National tax
Hokkaido 5650573 2522295 270504 145293 1379098
Aomori 1479358 551806 74341 32498 242730
Iwate 1405060 488354 72456 34152 224269
Miyagi 2350026 856527 115297 61092 735121
Akita 1173722 410308 65300 27294 186373
Yamagata 1225990 387732 70523 29851 202270
Local tax Agricultural output Forestry output Fishery catches
Hokkaido 546638 10579 463.7 761331
Aomori 131442 2402 88.2 107727
Iwate 123476 2587 193.4 108752
Miyagi 245372 1870 76.1 373037
Akita 97512 2208 123.2 5599
Yamagata 107894 2349 62.5 4116
Factories Industrial shipments Employed persons Commercial sales
Hokkaido 10668 51199 2796200 20247834
Aomori 3188 10997 731000 3693933
Iwate 4126 20209 715500 3525821
Miyagi 5782 32677 1169800 10933309
Akita 4130 11731 571000 2714120
Yamagata 5971 26287 631400 2968623
Electricity consumption Deposits and savings Public works expenditure
Hokkaido 11256 336487 1611254
Aomori 2671 70174 324170
Iwate 2631 76438 339411
Miyagi 4396 125693 391923
Akita 2152 56790 328282
Yamagata 2327 67083 363756
Housing starts Automobiles Education expenditure
Hokkaido 49183 3720320 945495
Aomori 8971 999912 264053
Iwate 8906 983234 277808
Miyagi 19382 1557230 365365
Akita 6664 831589 214608
Yamagata 7088 920699 215490
Book and magazine sales Newspaper circulation Televisions
Hokkaido 177154 2235101 1652081
Aomori 40213 531167 470546
Iwate 35185 471524 443942
Miyagi 70995 812314 719845
Akita 30773 442938 385189
Yamagata 29966 462638 371689
Telephone lines Mail volume Area
Hokkaido 6154045 650837 83455
Aomori 1384375 114626 9607
Iwate 1300483 114618 15279
Miyagi 2525483 351549 7286
Akita 1087529 93834 11612
Yamagata 1127332 105540 9323Step1 : データを基準化する.すなわち,平均値を0,標準偏差を1にする.
scaled.ppower = scale(Ppower, scale = T)round(apply(scaled.ppower, 2, mean),3) Population Households Establishments
0 0 0
Prefectural income National tax Local tax
0 0 0
Agricultural output Forestry output Fishery catches
0 0 0
Factories Industrial shipments Employed persons
0 0 0
Commercial sales Electricity consumption Deposits and savings
0 0 0
Public works expenditure Housing starts Automobiles
0 0 0
Education expenditure Book and magazine sales Newspaper circulation
0 0 0
Televisions Telephone lines Mail volume
0 0 0
Area
0 round(apply(scaled.ppower, 2, sd),3) Population Households Establishments
1 1 1
Prefectural income National tax Local tax
1 1 1
Agricultural output Forestry output Fishery catches
1 1 1
Factories Industrial shipments Employed persons
1 1 1
Commercial sales Electricity consumption Deposits and savings
1 1 1
Public works expenditure Housing starts Automobiles
1 1 1
Education expenditure Book and magazine sales Newspaper circulation
1 1 1
Televisions Telephone lines Mail volume
1 1 1
Area
1 Step2 : 新たな変数の分散を最大にする係数 \bm{\phi}_{1} を求める.データが基準化されていれば,z_{1} の平均は0である.すなわち, \bar{z}_{1} = \frac{1}{n}\sum_{i=1}^{n}z_{i1} = \phi_{11}\bar{x}_{1} +\cdots + \phi_{1p}\bar{x}_{p} = 0 である.したがって,新たな変数z_{1}の分散は \frac{1}{n}\sum_{i=1}^{n}z_{i1}^{2} = \frac{1}{n}\sum_{i=1}^{n}(\bm{\phi}_{1}^{T}\bm{x}_{i})^{2} となる.ただし \|\bm{\phi}_{1}\|_{2}^{2} = \bm{\phi}_{1}^{T}\bm{\phi}_{1} = 1 としておく.この条件がなければ分散はいくらでも大きくなってしまうためである.
このような分散最大化は,2次元平面で考えれば,データをその直線に落としたときに最もばらつくような方向を探していることになる.すなわち,データを最も解釈しやすい方向を探している.
Step3 : Step2で求めた \bm{\phi}_{1} に直交する \bm{\phi}_{2} の中で再び分散最大なものを求める.すなわち, \frac{1}{n}\sum_{i=1}^{n}z_{2i}^{2} = \frac{1}{n}\sum_{i=1}^{n}(\bm{\phi}_{2}\bm{x}_{i})^{2} を条件 \|\bm{\phi}_{2}\|_{2}^{2} = 1 と \bm{\phi}_{1}^{T}\bm{\phi}_{2} = 0 のもとで最大化する.これは,Step2で求めた新しい変数の軸とは直交する空間に限定し,再び解釈のしやすい方向を探している.
Step4 : これを削減したい次元の数だけ繰り返す.最大値はもちろん p である.
詳細は割愛するが,求めた \bm{\phi}_{1},\dots, \bm{\phi}_{k} は標本共分散行列の固有ベクトルと一致する.すなわち,標本共分散行列 S = \frac{1}{n}X^{T}X = \frac{1}{n}\sum_{i=1}^{n}\bm{x}_{i}\bm{x}_{i}^{T} の固有値を \lambda_{1} \ge \cdots \ge \lambda_{p} \ge 0 とし,対応する固有ベクトルを \bm{v}_{1},\dots,\bm{v}_{p},ただし正規直交 \bm{v}_{i}^{T}\bm{v}_{j} = 0\;(i\neq j),\quad \|\bm{v}_{i}\|_{2}^{2} = 1 するように取っておくと,\bm{\phi}_{j} = \bm{v}_{j}\;(j=1,2,\dots, p) である.
Step5 : 削減したい次元の分だけ主成分スコアを計算する,すなわち, z_{i1} = \bm{\phi}_{1}^{T}\bm{x}_{i},\quad z_{i\ell} = \bm{\phi}_{\ell}^{T}\bm{x}_{i} 例えば \ell=2 として主成分スコアをプロットすると,p 次元のデータを2次元平面にプロットしてデータを解釈することができるようになる.
実際にRでやってみよう.
sigma = t(scaled.ppower) %*% scaled.ppower

result = eigen(sigma) #固有値・固有ベクトルの計算
evalue = result$values #固有値の抽出
evector = result$vectors
第2主成分スコアまで計算してプロットしてみる.
z1 = scaled.ppower %*% evector[,1]
z2 = scaled.ppower %*% evector[,2]plot(z1, z2)
text(z1, z2, row.names(scaled.ppower), cex = 0.8, pos = 3)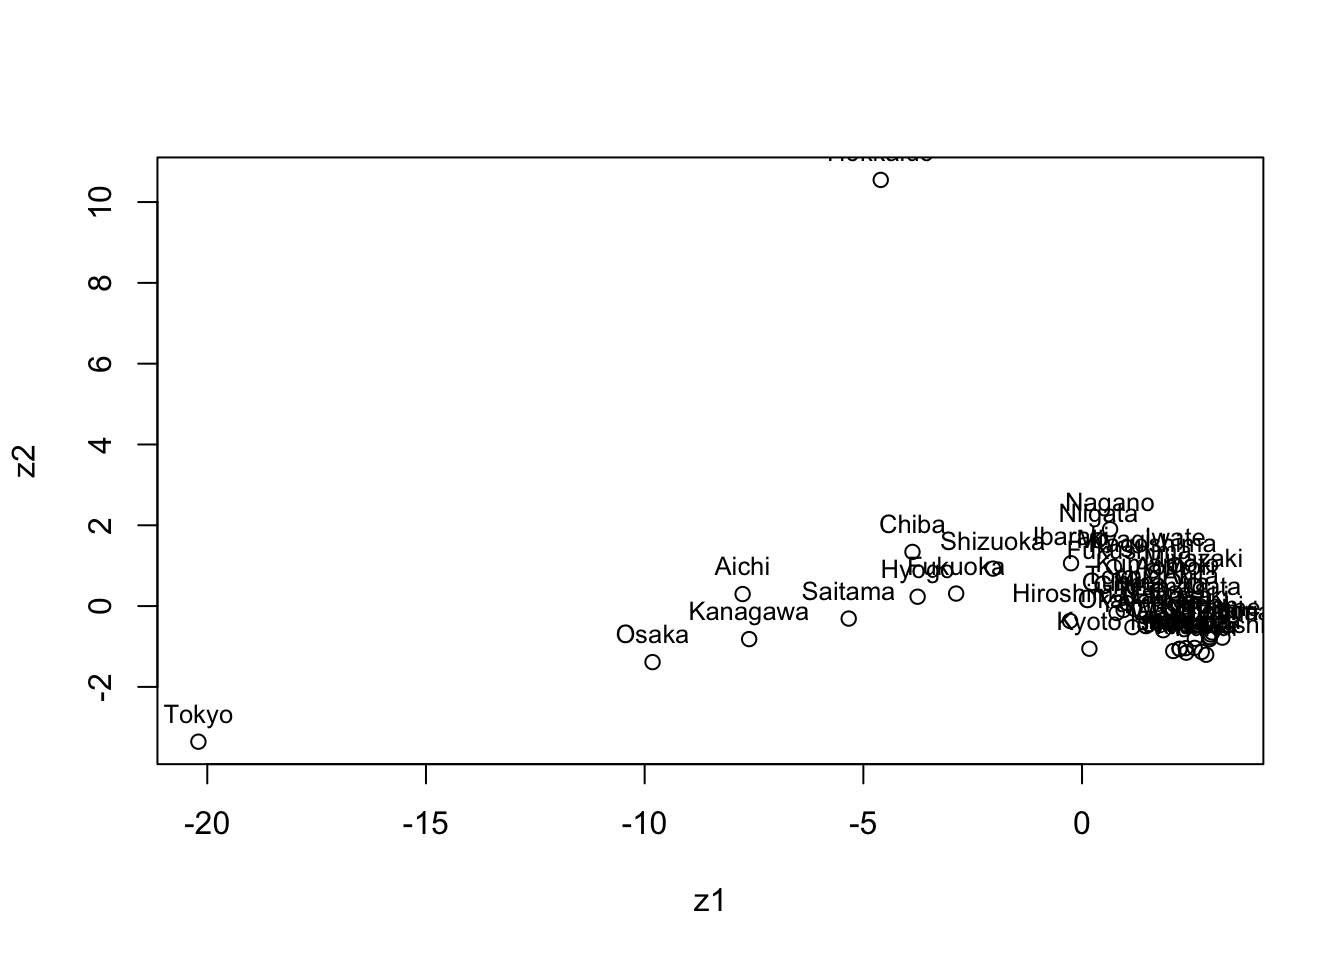
Exercise 5.1
主成分スコアは互いに無相関であることを数式上とR上で確認せよ.
2.1 主成分スコアの解釈
第2主成分スコアまで書き下すと,
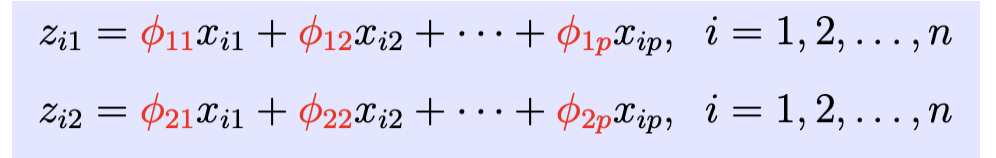
となっている.そのため,赤字の係数を大きさを見ることでその主成分スコアがどの変数を重要視しているかがわかる.
rownames(evector) = colnames(scaled.ppower)
round(evector[,1],3)
Population Households Establishments
-0.225 -0.227 -0.228
Prefectural income National tax Local tax
-0.229 -0.207 -0.212
Agricultural output Forestry output Fishery catches
-0.024 0.016 -0.044
Factories Industrial shipments Employed persons
-0.207 -0.156 -0.227
Commercial sales Electricity consumption Deposits and savings
-0.205 -0.228 -0.223
Public works expenditure Housing starts Automobiles
-0.212 -0.227 -0.208
Education expenditure Book and magazine sales Newspaper circulation
-0.223 -0.228 -0.228
Televisions Telephone lines Mail volume
-0.226 -0.229 -0.209
Area
-0.019 round(evector[,2],3) Population Households Establishments
0.033 0.022 0.001
Prefectural income National tax Local tax
-0.023 -0.120 -0.089
Agricultural output Forestry output Fishery catches
0.508 0.399 0.453
Factories Industrial shipments Employed persons
-0.059 0.020 0.021
Commercial sales Electricity consumption Deposits and savings
-0.105 0.010 -0.082
Public works expenditure Housing starts Automobiles
0.176 -0.039 0.134
Education expenditure Book and magazine sales Newspaper circulation
0.095 -0.036 -0.008
Televisions Telephone lines Mail volume
0.028 -0.025 -0.118
Area
0.504 これらの \bm{\phi}_{1}, \bm{\phi}_{2} の中身を見てみると,\bm{\phi}_{2} ではAgricultural output,Forestry output,Fishery catches,Areaなどが大きな値を持っており,一次産業の主成分だと解釈できる.それに直交する \bm{\phi}_{1} は工業やサービス業などの非一次産業の主成分であろう.
主成分スコアと固有ベクトルをbiplotで描いてみると解釈しやすい場合もある.
biplot(cbind(z1,z2), evector[,1:2], xlim = c(-23,8), ylim = c(-4,12), cex = 0.85)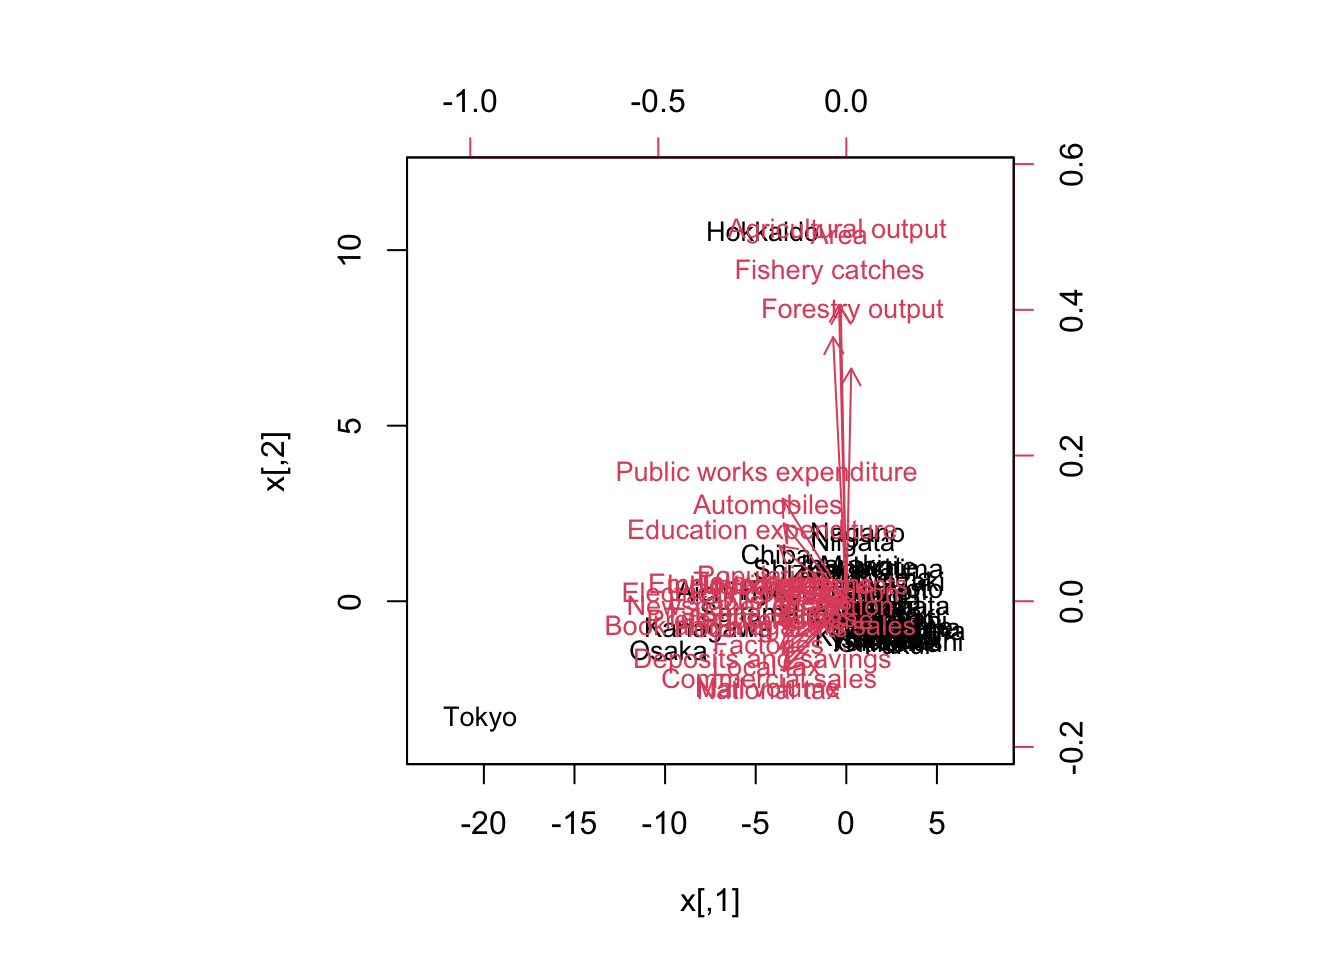
2.2 寄与率
プロットが目的ではなく,データの次元削減のみが目的である場合,主成分数 k はいくらにすればいいだろうか?これは,累積寄与率がひとつの尺度になる.累積寄与率は,標本共分散行列の固有値の総和に占める,主成分数に対応する固有値の和で定義される.すなわち,第2主成分まで使う場合の累積寄与率は, \frac{\lambda_{1} + \lambda_{2}}{\lambda_{1}+\lambda_{2}+\cdots + \lambda_{p}} である.累積寄与率が一定より大きくなる(0.8~0.9)主成分数まで用いるのが典型的な決定方法である.
累積和を計算するcumsum関数を用いると,今回の場合は以下のようになる.
round(cumsum(evalue)/sum(evalue),3) [1] 0.758 0.892 0.943 0.968 0.979 0.987 0.993 0.997 0.998 0.999 0.999 0.999
[13] 1.000 1.000 1.000 1.000 1.000 1.000 1.000 1.000 1.000 1.000 1.000 1.000
[25] 1.000そのため,今回の場合は k=2 において基準を満たしている.プロットして視覚的に確認することもある.
plot(1:dim(sigma)[1], cumsum(evalue)/sum(evalue), xlab = "principal component", ylab = "cumulative proportion")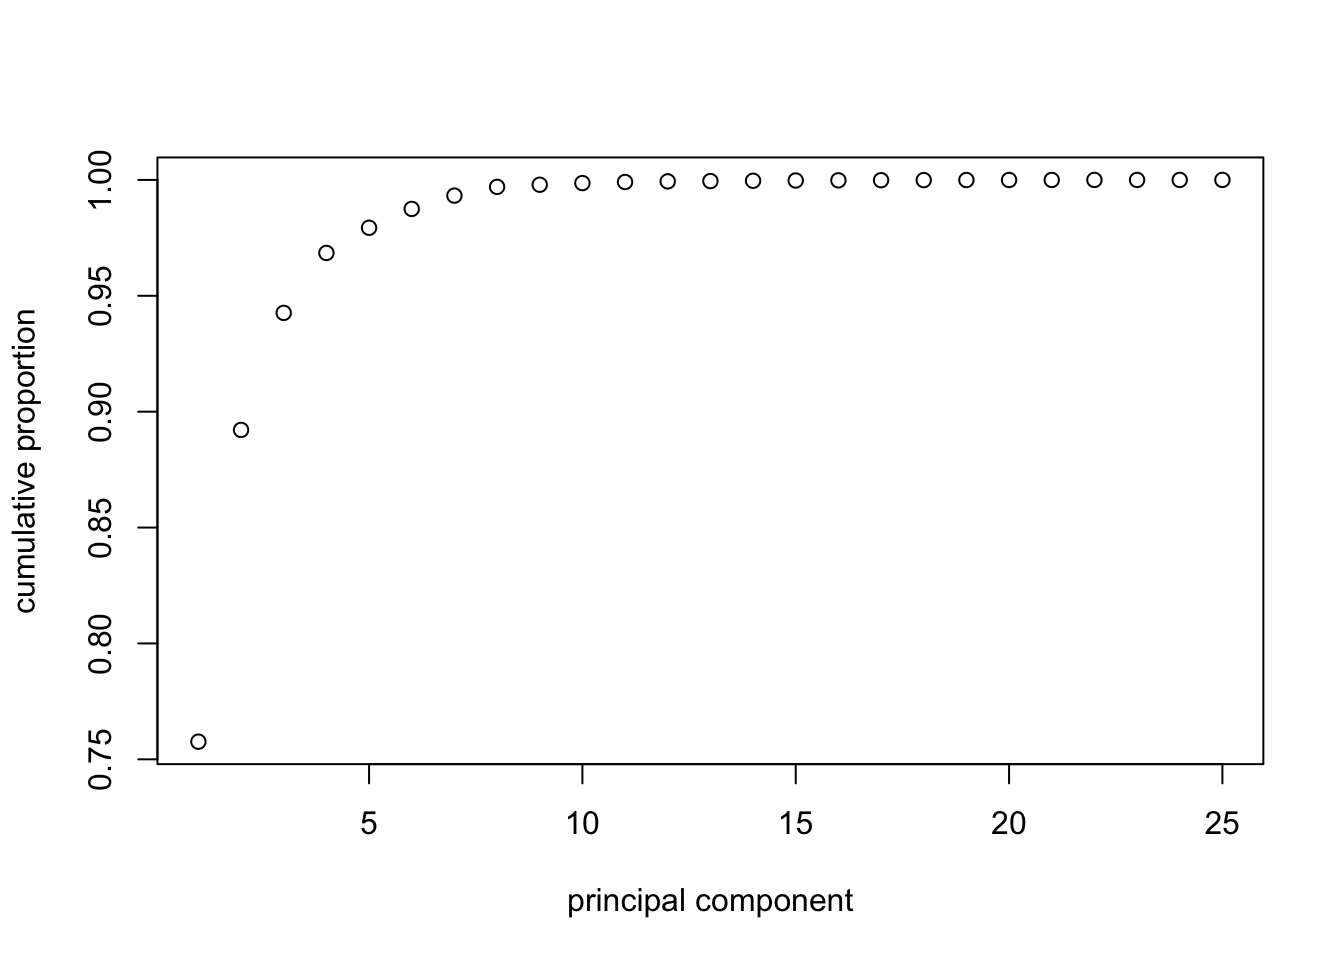
これはx軸に主成分数,y軸に累積寄与率を取っている.y軸の値が基準の数値を超える主成分数を選択すればよい.
2.3 特異値分解との関連性
累積寄与率でなぜ主成分数を評価できるのであろうか?これは特異値分解と密接に関係している.標本共分散行列 S の固有値\lambda_{i}と固有ベクトル\bm{v}_{i}はそれぞれ次のように定義される. S\bm{v}_{i} = \lambda_{i}\bm{v}_{i},\quad i=1,2,\dots, p ここで,S = \frac{1}{n}X^{T}X = \tilde{X}^{T}\tilde{X} であり,\tilde{X} = \frac{1}{\sqrt{n}}X とする.このとき非0の固有値は r = {\rm rank}(X) だけ存在し(その他の p-k 個は0),\lambda_{1}\ge \cdots \ge \lambda_{r} > 0と降順にしておく.このとき, \bm{u}_{i} = \frac{1}{\sqrt{\lambda_{i}}}\tilde{X}\bm{v}_{i},\quad i=1,2,\dots, r とおくと,定義から \|\bm{u}_{i}\|_{2}^{2} = 1 である.
行列表記で記述すると,特異値分解が見えてくる.簡単のため r=p を仮定する. U = (\bm{u}_{1},\dots, \bm{u}_{r}),\quad V = (\bm{v}_{1},\dots, \bm{v}_{r}),\quad D = {\rm diag}(\sqrt{\lambda_1},\dots, \sqrt{\lambda_r}) このとき, \begin{align*} U &= \bigg(\frac{1}{\sqrt{\lambda_1}}\tilde{X}\bm{v}_{1},\dots, \frac{1}{\sqrt{\lambda_r}}\tilde{X}\bm{v}_{r}\bigg) = \tilde{X}\bigg(\frac{\bm{v}_{1}}{\sqrt{\lambda_1}},\dots,\frac{\bm{v}_{r}}{\sqrt{\lambda_r}}\bigg) \\ &=\tilde{X}V{\rm diag}\bigg(\frac{1}{\sqrt{\lambda_1}},\dots, \frac{1}{\sqrt{\lambda_r}}\bigg) = \tilde{X}VD^{-1} \end{align*} となり,VV^{T} = I よりしたがって \tilde{X} = UDV^{T} を得る.これは \sqrt{n} でscalingされたデータ行列Xの特異値分解に他ならない.対角行列 D の構成要素は S の固有値であり,累積寄与率は行列 \tilde{X} の近似の度合いを評価している.
Exercise 5.2
固有値・固有ベクトルと特異値分解の関係性を用いて,最初の潜在意味分析における解析を,標本共分散行列の固有値・固有ベクトルから再構成せよ.